


昨天替鏢局增添 通行守衛 和 金鑰保險箱 ,
今天終於可以安心請俠客 Google Cloud Speech-to-Text 出手!
這次想解決兩個實際需求:
能不能每次都辨識正確?
完整辨識出句子?
今天就從實測結果出發,看看 Google Cloud STT 能替健口動一動做到哪些事!
平常說一句話,前後文能提供線索。
只念一個「踏」,模型的輸出會是預期的那個字嗎?
健口動一動的開發需求,還會特別關注:
正確性:「踏」「卡」分不清、漏字少輸出穩定性:同樣的發音,模型吐的結果都維持相同| 我錄的內容 | Chirp 2 | Chirp 3 |
|---|---|---|
| 怕 | 八 | 怕 |
| 踏 | 他 | 他 |
| 卡 | 卡 | 卡 |
| 啦 | 啦 | 辣 |
結果:「卡」兩邊都辨識出來了,其他幾個音則出現不同的字。
實務上,
做 prototype 時,我就遇過同樣發音但辨識結果是其他字(例如:怕,辨識結果 帕)。
健口動一動的小遊戲(詳見下方),是透過語音辨識判別操作的指令。
所以,我的做法是寬鬆比對,將同音或近音字映射成相同指令。
| 錄音內容 | Chirp 2 原始文字 | Chirp 3 原始文字 |
|---|---|---|
| 怕 × 8 | 帕帕帕帕帕 | 怕怕怕怕怕 |
| 踏 × 8 | 他他他他他 | 他他他他他 |
| 卡 × 8 | 卡卡卡卡卡 | 卡卡卡卡卡 |
| 啦 × 8 | 啦啦啦啦啦 | 啦啦啦啦啦 |
結果:四個音分別念八次:輸出結果都只有五個字
為了確認是不是偶發情況,
我把同一份「怕×8」的錄音,再交給兩個模型各辨識 30 次。
結果仍然一樣:每次輸出都只有五個字。
目前也不知道為什麼會有這麼穩定的漏字XD
接著想確認,是不是跟「念了幾次」有關。
我先用語音合成產生一個「怕」,再把這段聲音複製、接在一起,
做成重複 4 次、5 次、6 次、7 次、8 次的五份音檔,分別送給兩個模型辨識。
兩個模型的結果都是:4 次回 4 字、5 次回 5 字,6 次以上,全部停在 5 個字。
看起來比較像輸出有「最多 5 個」的上限,但從 API 回傳的內容,無法確認原因。
這個現象,我有回報到 Google 的 Issue Tracker:Issue #567868709
語音調整(Speech Adaptation),先提供可能出現的詞,讓模型辨識時多留意它們。
這次添加四個提示字:怕、踏、卡、啦
| 設定 | 做了什麼 |
|---|---|
| 關閉語音調整 | 不提供提示詞 |
| 開啟語音調整、不設 boost | 提供提示詞,不額外指定加權值 |
| 開啟語音調整、boost = 5 | 提供同一份提示詞,並指定加權值 5 |
boost 的數字怎麼選?
boost的數值可以設定 0~20,官方建議用實際音檔比較,再逐步調整。
數值提高時,也可能更容易出現「沒說卻辨識出來」的詞。
以 Chirp 3 的部分結果來看:
| 錄音內容 | 未開調整 |
開調整、不設 boost |
開調整、boost = 5 |
|---|---|---|---|
| 踏 | 他 | 踏 | 踏 |
| 啦 | 辣 | 啦 | 啦 |
| 怕踏卡啦,兩輪 | 怕他卡拉怕他卡拉 | 怕踏卡啦怕踏卡啦 | 怕踏卡啦怕踏卡啦 |
| 怕,八次 | 怕怕怕怕怕 | 怕怕怕怕怕 | 怕怕怕怕怕 |
結果:單音辨識更符合預期了,重複音的漏字問題,仍然存在。
本輪使用 13 個既有音檔,
讓 Chirp 2、Chirp 3 分別在「開整、不設 boost」與「開調整、boost=5」下,
各辨識 3 次,共完成 156 次請求。
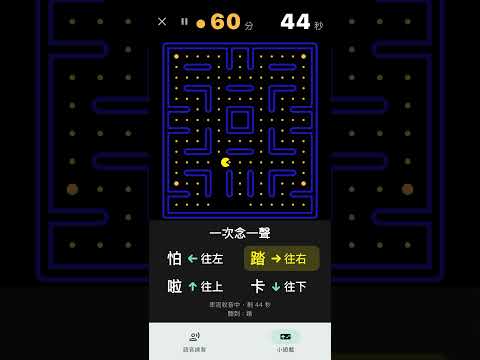
實測影片:
https://youtube.com/shorts/_I7yjjogxy8?feature=share
辨識方式:串流辨識
選用模型:Chirp3
語音調整:怕、踏、卡、啦,四字。
辨識正確性:有正確辨識單音節發音(符合別名映射)
辨識穩定性:後續幾場,偶有不穩定、混淆情況(唸踏,辨識成怕),可能需要多驗證。
繞口令也是日本口腔體操的其中一項訓練,對語音辨識模型也是一項挑戰:
第一段:
繞口令:四是四,十是十,十四是十四,四十是四十。
| 模型 | 原始辨識文字 |
|---|---|
| Chirp 2 | 四是四十是十十四是十四四十是四十 |
| Chirp 3 | 4是4,10是10,14是14,40是40。 |
結果:兩個模型都轉出了對應內容,但 Chirp 2 使用漢字,Chirp 3 則使用阿拉伯數字,並加上標點。
對 App 來說,「十四」和「14」表達相同的數字,
直接逐字比對,卻可能把格式差異也算成錯誤。
比對前,可以先做文字正規化,統一標點、空白與數字格式。
並且保留原始辨識文字,方便回頭核對。
第二段:
吃葡萄不吐葡萄皮,不吃葡萄倒吐葡萄皮。
| 模型 | 原始辨識文字 |
|---|---|
| Chirp 2 | 吃葡萄不吐葡萄皮不吃葡萄倒吐葡萄皮 |
| Chirp 3 | 吃葡萄不吐葡萄皮,不吃葡萄倒吐葡萄皮。 |
結果:兩個模型都完整保留了句子內容,差別主要在標點。
練習時,我們也會想知道自己哪裡念錯。
這就需要模型忠實留下實際念法,才能進一步比對。
另一份錄音,我把「十是十」念成「十是四」:
四是四,十是四,十四是十四,四十是四十。
| 模型 | 原始辨識文字 |
|---|---|
| Chirp 2 | 四十四十四十四四十四四十四四十 |
| Chirp 3 | 441414是1440是40 |
結果:兩個模型都沒有完整保留實際念出的句子,
因此難以從辨識文字可靠地定位「十是四」這個錯讀位置。
所以,即使正常朗讀時能順利轉成文字,讀錯時是否仍能忠實記錄,可能需要再確認。
今天從單音、重複音到繞口令,
實際看了 Cloud STT 在不同練習情境下的表現:
經過這次的實測,雖然發現:可能有無法滿足開發需求的點。
但我真的覺得 Chirp 3 相較於我去年試的 Chirp 1,真的有大大的變強XD
尤其今天測小遊戲的時候,Chirp 3 加上 Adaptation ,整場小遊戲沒有辨識錯誤,這一點我特別感動!
因為做prototype時,辨識 「踏」「卡」很常混淆,就會看到小精靈的方向一直走錯XDD
今天看了 Cloud STT 在健口動一動 App 的實測,
可是 App 端究竟如何實作同步辨識、串流辨識?
明天就讓我們繼續看下去吧!
感謝有緣看到這邊的你~
希望佛菩薩也祝福你:🌟開心幸福 健康順遂🌟
南無觀世音菩薩🍀 南無地藏菩薩🏠 南無阿彌陀佛☀️


 iThome鐵人賽
 看影片追技術